DevOps e Deployment Pipeline Design: Quando a Velocidade de Entrega Define a Capacidade de Competir
Cases de Netflix, Etsy e Capital One revelam como pipelines de CI/CD bem arquitetados transformam velocidade de entrega em vantagem competitiva
Em janeiro de 2012, a Etsy realizava deploys em produção duas vezes por semana. Cada deployment exigia uma “deployment army” — múltiplos engenheiros coordenados durante 6 a 14 horas, frequentemente resultando em downtime programado e noites longas de correções emergenciais. Três anos depois, a mesma empresa executava mais de 50 deploys por dia, com qualquer engenheiro — incluindo novos contratados em seu primeiro dia — capaz de enviar código para produção com um único clique. A transformação não veio de uma ferramenta mágica, mas de uma reimaginação completa do que significa entregar software.
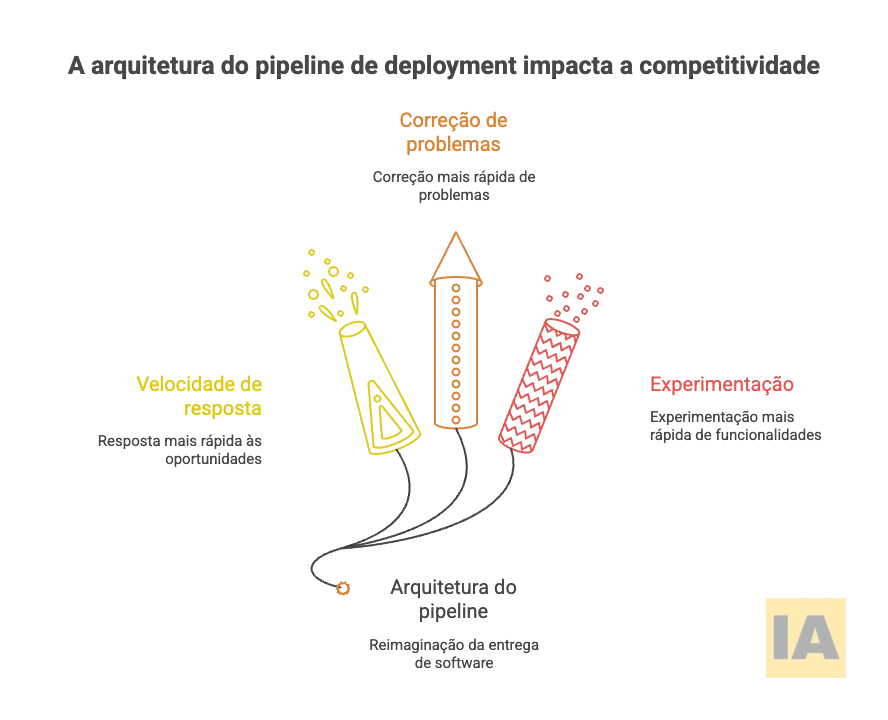
Esta evolução ilustra uma verdade frequentemente subestimada: a arquitetura do pipeline de deployment não é apenas uma preocupação técnica — é um diferencial competitivo que determina a velocidade com que uma organização pode responder a oportunidades de mercado, corrigir problemas e experimentar novas funcionalidades.
As Métricas que Definem Excelência: O Framework DORA
Antes de examinar arquiteturas específicas, é essencial estabelecer como medir eficácia. O DevOps Research and Assessment (DORA), originado no Google Cloud, identificou quatro métricas que consistentemente distinguem equipes de alta performance:
- Deployment Frequency mede com que frequência código chega à produção. Equipes elite deployam múltiplas vezes ao dia; equipes de baixa performance, mensalmente ou com menor frequência.
- Lead Time for Changes captura o tempo desde o commit até a execução em produção — elite performers medem em horas, não semanas.
- Change Failure Rate indica a porcentagem de deployments que causam falhas em produção, idealmente abaixo de 15%.
- Mean Time to Recovery (MTTR) quantifica quanto tempo leva para restaurar serviço após uma falha — minutos para os melhores, dias para os piores.
Pesquisas multi-anuais demonstram que organizações com métricas DORA elite são duas vezes mais propensas a atingir metas organizacionais de performance. O insight crucial: velocidade e estabilidade não são trade-offs — equipes que deployam com mais frequência também experimentam menos falhas, porque cada mudança é menor e mais fácil de diagnosticar.
Anatomia de um Pipeline Moderno
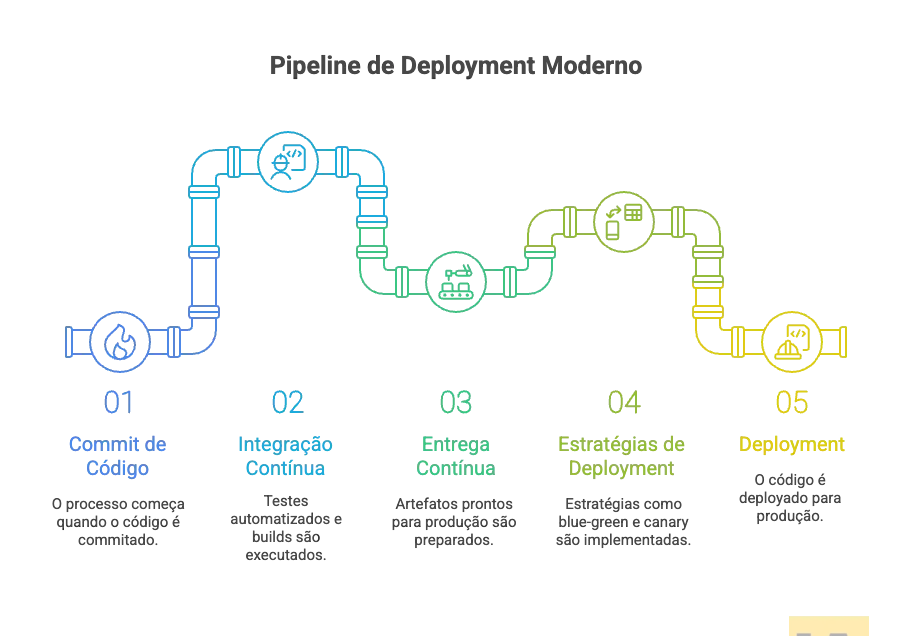
Um pipeline de deployment contemporâneo opera como uma linha de montagem sofisticada, onde cada estágio adiciona garantias antes que o código avance. A estrutura típica inclui:
Continuous Integration inicia quando código é commitado. Testes unitários, análise estática, verificação de dependências e build automatizado executam em paralelo. O princípio “fail fast” — identificar problemas o mais cedo possível — reduz dramaticamente o custo de correção. A Etsy desenvolveu o “Try”, uma biblioteca que permite engenheiros testarem mudanças em Jenkins antes mesmo de commitar ao trunk, mantendo a branch principal sempre deployável.
Continuous Delivery estende a automação até um artefato pronto para produção. Cada build que passa nos testes automatizados é um candidato a release. A diferença para Continuous Deployment é sutil mas significativa: em CD, um humano decide quando fazer release; em Continuous Deployment, cada build aprovado vai automaticamente para produção.
Deployment Strategies determinam como novas versões chegam aos usuários. Blue-green deployments mantêm duas versões idênticas do ambiente, alternando tráfego instantaneamente. Canary releases expõem a nova versão a uma pequena porcentagem de usuários antes do rollout completo. Rolling deployments atualizam instâncias gradualmente, mantendo capacidade durante a transição.
Netflix: Engenharia de Resiliência em Escala Global
A Netflix processa mais de um trilhão de eventos por dia, opera em mais de 190 países e não pode tolerar downtime durante o lançamento de uma nova temporada de série popular. Sua abordagem ao deployment transcende automação convencional para abraçar o que chamam de “engenharia de resiliência”.
O Spinnaker, plataforma de Continuous Delivery desenvolvida internamente e posteriormente open-sourced, orquestra deployments multi-cloud com estratégias sofisticadas de canary analysis. Antes de qualquer release completo, o sistema compara automaticamente métricas entre a versão atual (baseline) e a nova versão (canary) — CPU, latência, taxas de erro, pausas de garbage collection. Apenas se o score de canary atingir threshold saudável, o deployment prossegue.
Mais revolucionário foi o Chaos Monkey, parte do que a Netflix chama de “Simian Army”. Em vez de esperar falhas acontecerem, o Chaos Monkey deliberadamente termina instâncias de produção aleatoriamente, forçando engenheiros a construírem sistemas que sobrevivem a falhas desde o design inicial. O Chaos Gorilla simula a perda completa de uma região AWS. A filosofia subjacente: em sistemas distribuídos, falhas são inevitáveis; a única questão é se você está preparado para elas.
O resultado mensurável: quando a AWS reiniciou 10% de seus servidores em setembro de 2014 sem aviso, a Netflix continuou operando normalmente — enquanto concorrentes experimentaram interrupções significativas. Em 2017, a empresa ultrapassou um milhão de containers Docker lançados por semana, gerenciados pelo Titus, seu sistema proprietário de orquestração de containers integrado profundamente com a infraestrutura AWS.
Etsy: Democratização do Deployment
Se a Netflix representa escala massiva, a Etsy exemplifica como organizações menores podem atingir velocidade extraordinária através de simplicidade radical e cultura de ownership.
O Deployinator, ferramenta desenvolvida internamente, reduziu deployment a um único botão em interface web. Antes da transformação, eram necessários no mínimo três engenheiros de desenvolvimento, um de operações e um de produção em standby. Depois, qualquer pessoa — incluindo designers, product managers e até membros do board — podia enviar código para produção em menos de dois minutos.
Feature flags tornaram-se parte integral do processo. Novas funcionalidades são deployadas “escuras” — o código existe em produção mas está desabilitado. Gradualmente, a feature é habilitada para percentuais crescentes de usuários, permitindo validação de comportamento antes do rollout global. Se problemas surgem, desabilitar a flag é instantâneo, sem necessidade de rollback de código.
A obsessão por métricas define a cultura técnica da Etsy. O StatsD, também desenvolvido internamente e posteriormente open-sourced, permite que qualquer aspecto do sistema seja grafado em tempo real. A política explícita: se pode ser medido, deve ser medido. Dashboards enormes dominam o escritório, permitindo que qualquer pessoa identifique correlações entre deployments (linhas verticais nos gráficos) e mudanças de comportamento do sistema.
Blameless post-mortems completam o ciclo. Quando incidentes ocorrem, a investigação foca em aprendizado sistêmico, não em atribuição de culpa. “Mistakes happen,” resume a filosofia. “We find them, fix them, and move on. The important thing is to learn something from the process.”
Capital One: DevOps em Ambiente Regulado
A transformação da Capital One desafia a noção de que indústrias fortemente regulamentadas não podem adotar práticas DevOps agressivas. Em 2010, o banco americano enfrentava ciclos de release de 6 a 9 meses — inaceitável em um mercado financeiro cada vez mais digital.
A jornada começou com times SWAT cross-funcionais dedicados a aplicações legadas específicas. Esses times implementaram configuration management, automatizaram processos críticos e estabeleceram workflows replicáveis. O sucesso foi então escalado horizontalmente para outras aplicações.
A migração para microservices permitiu que diferentes equipes deployassem independentemente, sem coordenação centralizada massiva. Em 2020, a Capital One tornou-se o primeiro banco americano a anunciar migração completa de data centers on-premises para cloud pública (AWS), fechando oito data centers físicos.
O Hygieia, dashboard DevOps desenvolvido internamente e open-sourced, proporciona visibilidade end-to-end do pipeline de entrega — desde commits até produção, incluindo métricas de qualidade, cobertura de testes e compliance. Para uma instituição financeira, auditabilidade não é opcional; o Hygieia transforma essa necessidade regulatória em vantagem operacional.
Seguindo o exemplo da Netflix, a Capital One implementou “Cloud Detour”, sua versão de chaos engineering, testando resiliência de aplicações contra cenários de falha diversos. O resultado documentado: redução de 70% no tempo de disaster recovery em testes, e evolução de atualizações trimestrais/mensais para releases frequentes.
A integração de segurança no pipeline (DevSecOps) eliminou o processo manual e demorado de certificação de segurança. Verificações automatizadas de vulnerabilidades em containers e imagens de VM executam como estágios do pipeline, com APIs permitindo que times de desenvolvimento obtenham relatórios e iniciem correções sem envolver a equipe de segurança diretamente.
GitOps: Git como Fonte de Verdade Universal
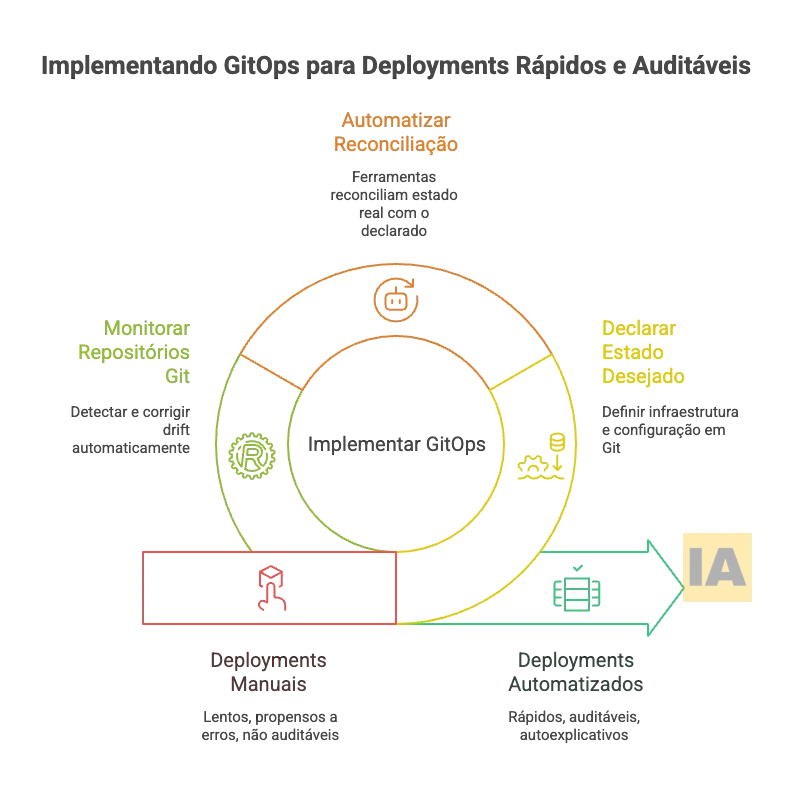
O paradigma GitOps representa a evolução mais recente em deployment pipeline design, tratando infraestrutura e configuração de aplicações com o mesmo rigor que código fonte. O princípio central: o estado desejado do sistema é declarado em repositórios Git, e ferramentas automatizadas continuamente reconciliam o estado real com o declarado.
ArgoCD, projeto open-source da Cloud Native Computing Foundation, implementa GitOps para Kubernetes. Como controller Kubernetes, monitora repositórios Git e clusters simultaneamente, detectando e corrigindo drift automaticamente. Se alguém modifica manualmente um recurso no cluster, ArgoCD detecta a divergência e pode reverter para o estado declarado em Git.
A Slite, empresa de software colaborativo, implementou GitOps com ArgoCD e Google Kubernetes Engine em apenas seis semanas. O resultado: capacidade de deployar até 20 vezes por dia, com bug fixes chegando à produção em apenas 15 minutos após identificação. Mais significativo: a empresa expandiu de 6 para 16 engenheiros sem perder momentum, porque o processo de deployment é transparente, auditável e autoexplicativo para novos membros.
Para organizações reguladas, GitOps oferece vantagem adicional: cada mudança em produção tem trail de auditoria completo — quem aprovou, quando, qual foi a mudança exata. Pull requests funcionam como mecanismo de aprovação, integrando naturalmente com processos de compliance existentes.
Arquiteturas de Pipeline: Escolhendo o Modelo Adequado
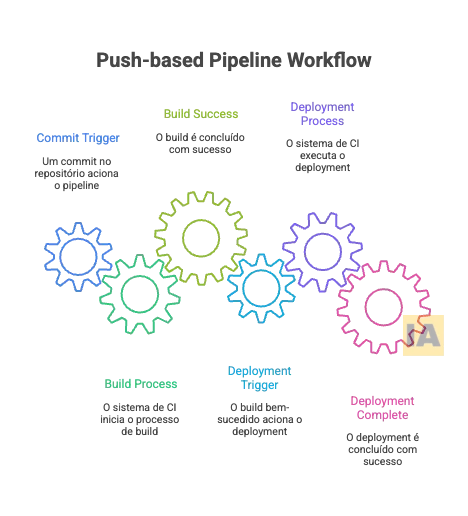
Push-based pipelines (Jenkins, GitHub Actions, Azure DevOps) executam ações em resposta a eventos — um commit trigger build, build bem-sucedido trigger deployment. São intuitivos e flexíveis, mas requerem credenciais de produção armazenadas no sistema de CI, criando superfície de ataque potencial.
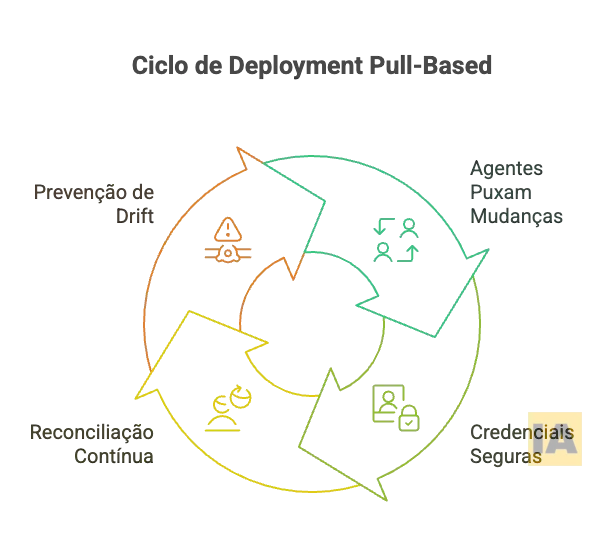
Pull-based pipelines (ArgoCD, Flux) invertem o modelo: agentes dentro do cluster de produção “puxam” mudanças de repositórios Git. Credenciais de produção nunca saem do ambiente de produção, melhorando postura de segurança. A reconciliação contínua previne drift.
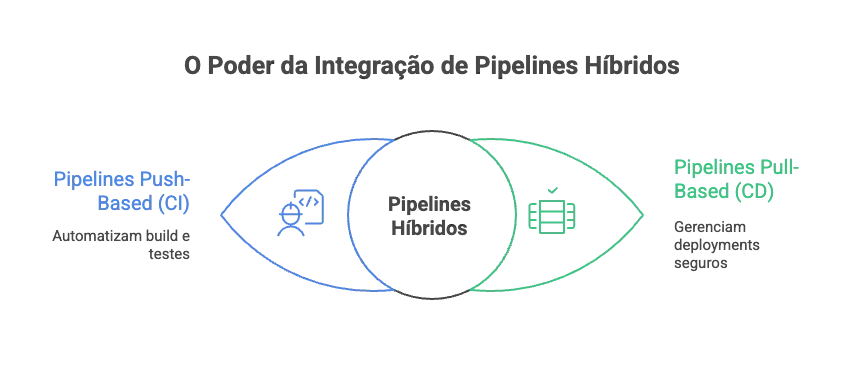
Hybrid approaches combinam CI push-based (para build e testes) com CD pull-based (para deployment), capturando benefícios de ambos modelos.
A escolha depende de contexto organizacional. Push-based funciona bem para equipes menores com infraestrutura diversa (não apenas Kubernetes). Pull-based escala melhor para organizações com múltiplos clusters Kubernetes e requisitos rigorosos de compliance.
Progressive Delivery: Além do Deploy Binário
Deployments tradicionais são binários: código antigo ou código novo. Progressive delivery introduz nuance, permitindo rollout gradual com validação em cada estágio.
Canary deployments expõem nova versão a pequena porcentagem de tráfego (1-5%), monitoram métricas automaticamente, e expandem apenas se indicadores permanecem saudáveis. A Netflix refinou isso com análise estatística automatizada — não apenas “métricas parecem ok” mas “diferença entre baseline e canary não é estatisticamente significativa para métricas críticas”.
Feature flags desacoplam deployment de release. Código chega à produção desabilitado, permitindo ativação gradual por segmento de usuário, região geográfica ou qualquer critério definido. Se problemas emergem, desabilitar é instantâneo — sem rollback de código, sem novo deployment.
A/B testing vai além, permitindo que múltiplas variantes coexistam em produção com usuários alocados aleatoriamente. Decisões de produto são informadas por dados de comportamento real, não suposições.
Observabilidade: O Alicerce Invisível
Pipelines sofisticados são inúteis sem observabilidade adequada. A tríade clássica — logs, métricas, traces — deve estar integrada ao pipeline desde o início.
Deployment markers em dashboards (linhas verticais indicando quando deployments ocorreram) permitem correlação visual imediata entre mudanças e comportamento do sistema. A Etsy elevou isso a arte, com painéis mostrando métricas de negócio, performance técnica e eventos de deployment sobrepostos.
Alerting automatizado deve distinguir entre sintomas e causas. SLOs (Service Level Objectives) definem comportamento aceitável; alertas disparam quando error budgets são consumidos, não quando métricas individuais cruzam thresholds arbitrários.
Distributed tracing torna-se essencial em arquiteturas de microservices. Quando uma requisição atravessa dezenas de serviços, identificar onde latência foi introduzida requer visibilidade end-to-end que logs isolados não proporcionam.
Conclusão: Velocidade como Capacidade Organizacional
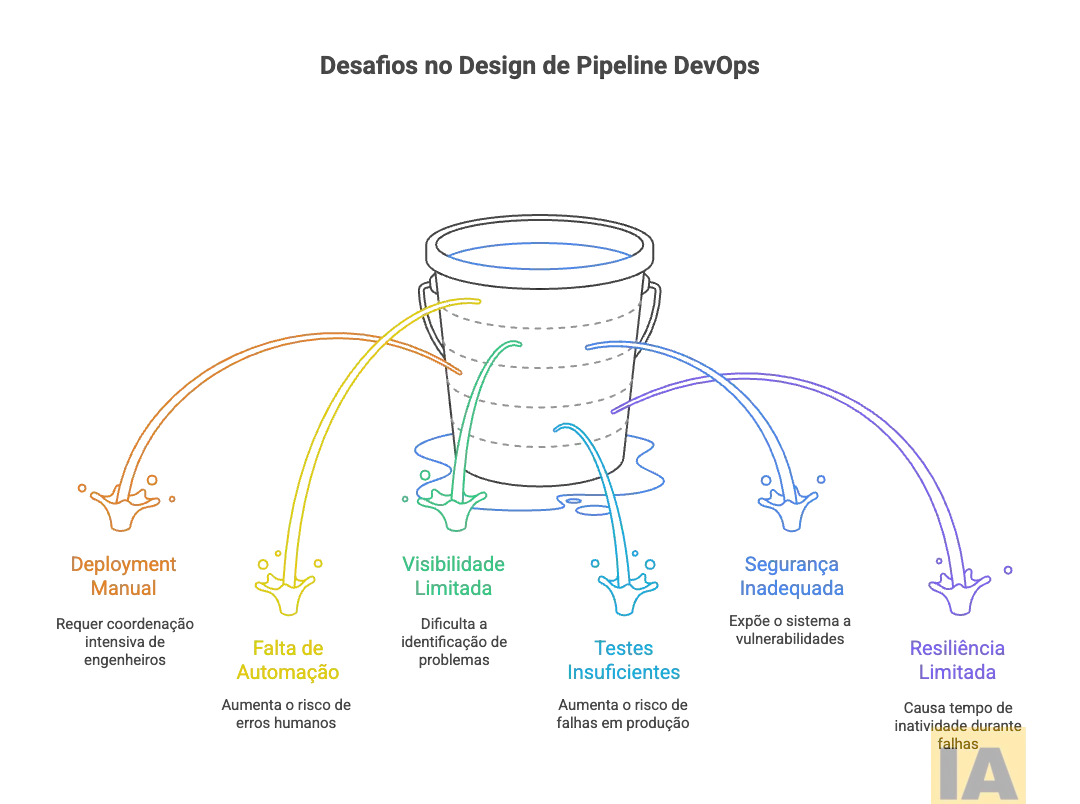
As transformações da Netflix, Etsy e Capital One compartilham padrão comum: deployment pipeline design não foi tratado como projeto técnico isolado, mas como capacidade organizacional estratégica. A Netflix precisava de resiliência global para competir em streaming; a Etsy precisava de agilidade para iterar rapidamente em seu marketplace; a Capital One precisava de velocidade digital para competir com fintechs — sem sacrificar compliance regulatório.
Não existe arquitetura de pipeline universalmente superior. Existe a arquitetura que transforma as restrições específicas de uma organização: sua cultura, seu stack tecnológico, seus requisitos regulatórios, sua tolerância a risco… em vantagem competitiva sustentável.
O denominador comum entre organizações de alta performance não é a ferramenta escolhida, mas a mentalidade subjacente: deployment deve ser evento rotineiro, não cerimônia excepcional. Quando enviar código para produção é trivial, experimentação floresce. Quando rollback é instantâneo, risco de mudança diminui. Quando métricas são ubíquas, decisões são informadas por dados, não intuição.
A pergunta que define maturidade DevOps não é “quantas vezes deployamos por dia” mas sim “quão confortável qualquer engenheiro está em deployar uma mudança agora mesmo?” A resposta a essa pergunta, e a arquitetura de pipeline que a viabiliza, frequentemente determina quem lidera mercados e quem apenas os segue.