A Memória dos Seus Agentes Está Quebrada
E provavelmente você ainda não percebeu
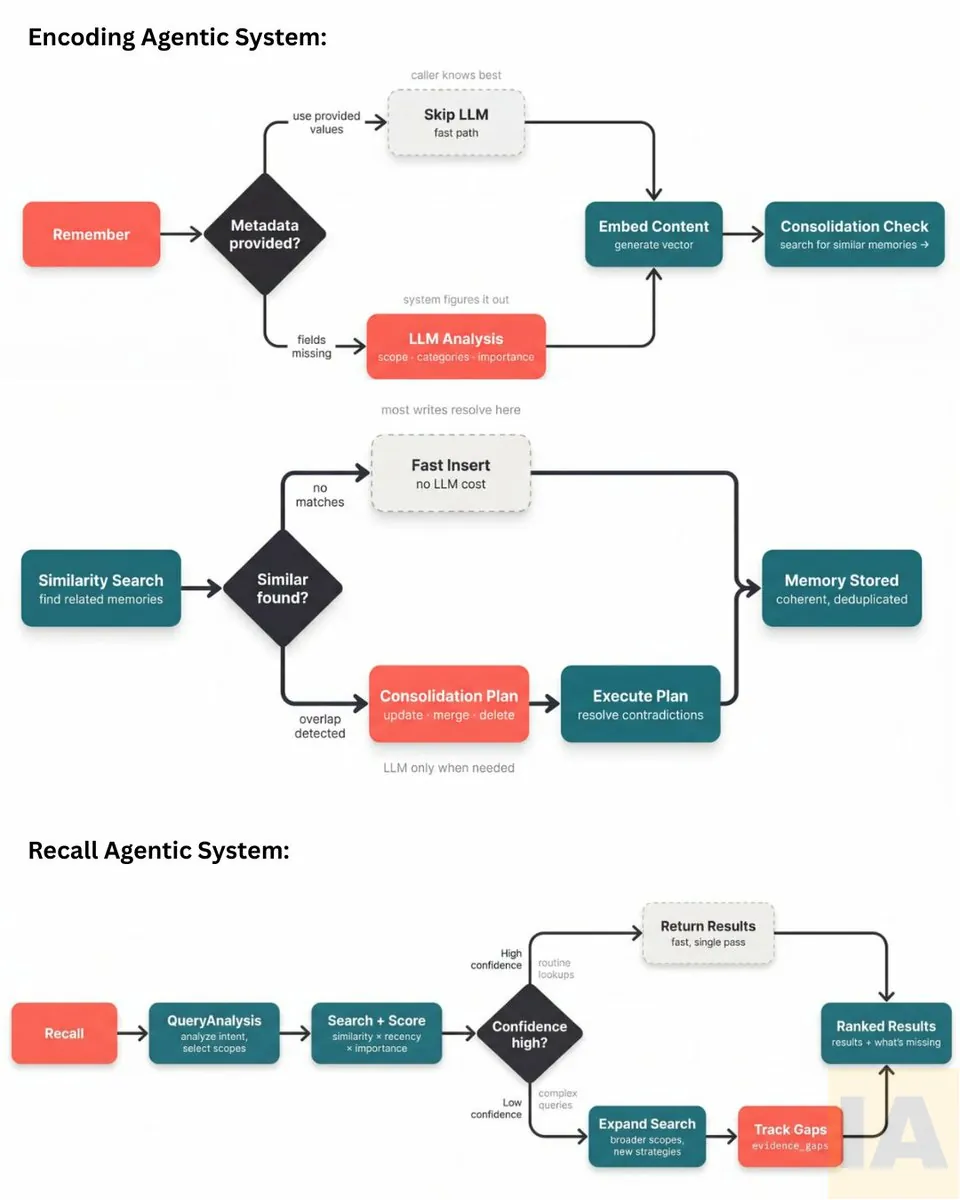
Quando um agente responde com convicção algo que está errado, a reação imediata é culpar o modelo. Mas na maioria dos casos, o modelo não é o problema. O problema está na arquitetura de memória que alimenta esse agente.
Esse artigo é sobre isso: como a memória de agentes falha silenciosamente em produção, por que o modelo padrão de armazenamento é insuficiente para sistemas reais, e como construir algo mais robusto usando três pilares — fatos atômicos, scoring composto e tratamento explícito de lacunas de evidência.
O código existe. A implementação é possível. Mas a maioria dos times nunca chega lá porque não percebe que o problema é arquitetural.
O modelo ingênuo e por que ele funciona no protótipo
A implementação padrão de memória para agentes segue um caminho intuitivo:
- Recebe um bloco de texto com informação relevante
- Gera um embedding do bloco inteiro
- Persiste o texto e o embedding em um vector store
- No recall, busca os mais similares via nearest neighbors
Em um protótipo, isso parece funcionar. As respostas fazem sentido. A demo impressiona.
O problema aparece quando o sistema cresce, os dados acumulam e as consultas ficam mais específicas.
As quatro falhas que surgem em produção
Context bleed
Quando múltiplos fatos são armazenados como um único bloco, o sistema não consegue distinguir qual parte da memória é relevante para qual pergunta.
Considere um bloco como: “Na reunião de terça decidimos usar Postgres porque o orçamento é limitado, a equipe já conhece SQL e vamos precisar de replicação futura.”
Esse bloco contém pelo menos quatro informações independentes: a decisão de tecnologia, a justificativa de custo, a competência do time e um requisito futuro. Quando você pergunta “qual banco de dados estamos usando?”, o sistema recupera o bloco inteiro e o modelo precisa interpretar qual parte responde à pergunta. Às vezes acerta. Às vezes extrapola.
Fact contamination
Atualizar uma informação específica dentro de um bloco exige regravar o bloco inteiro ou criar uma nova versão que compete com a anterior.
Se o orçamento aprovado muda de R$ 10.000 para R$ 15.000, você cria duas memórias semanticamente similares. Qual delas o sistema vai recuperar? Depende de qual foi indexada mais recentemente ou tem embedding mais próximo da query. Não há garantia de consistência.
Ranking incorreto
Similaridade vetorial pura tende a favorecer coincidência lexical e recência sobre importância real.
Em um sistema em uso há meses, uma nota trivial criada ontem — “erro temporário no banco de staging” — pode ter score de similaridade mais alto do que a decisão arquitetural registrada há seis meses — “banco principal do sistema é Postgres” — simplesmente porque compartilha mais palavras com a query “qual banco estamos usando?”.
O sistema responde com a nota trivial. O agente passa a mencionar um erro temporário como se fosse a configuração definitiva.
Alucinação operacional
Quando nenhuma memória recuperada tem evidência suficiente para responder com confiança, o modelo não tem mecanismo para reconhecer isso. Ele responde de qualquer forma, interpolando, extrapolando, inventando com fluência.
Esse comportamento não é falha do modelo em isolamento. É falha de uma arquitetura que não devolve ao modelo a informação de que a evidência é insuficiente.
A solução em três pilares
A proposta não é substituir o vector store. É construir uma camada de memória que pensa sobre o que armazena, como recupera e quando não sabe.
Pilar 1: Fatos atômicos
Em vez de armazenar blocos de texto, a memória armazena proposições discretas e autocontidas.
O bloco “Na reunião de terça decidimos usar Postgres porque o orçamento é limitado...” se transforma em:
database.primary = postgresbudget.phase_1.approved = R$ 10.000decision.date = 2026-02-11team.sql_competency = alta
Cada fato tem atributos próprios: texto canônico, embedding individual, tipo, nível de importância, confiança de extração, confiança de veracidade, referência temporal e proveniência.
Essa granularidade resolve o context bleed. Cada fato responde por si. A atualização de um fato não contamina os outros. O versionamento se torna rastreável.
A extração usa duas abordagens complementares: regras e parsers para padrões determinísticos como datas, valores monetários e identificadores; e um LLM extractor para proposições complexas como decisões, relações causais e contexto implícito.
@dataclass
class ExtractedFact:
    fact_type: str
    fact_key: str | None
    canonical_text: str
    normalized_value: dict | None
    importance: float
    extraction_confidence: float
    truth_confidence: float
    recency_reference_at: datetime | None
    metadata: dict
A importância não é aleatória. Cada tipo de fato tem uma faixa esperada:
- Decisão de arquitetura: 0.90 ou acima
- Orçamento aprovado: 0.85 ou acima
- Preferência estável do usuário: 0.80
- Observação operacional transitória: 0.20 a 0.40
Pilar 2: Scoring composto
O recall não pode depender apenas de similaridade semântica. Precisa combinar múltiplos sinais.
Os sinais relevantes são: similaridade vetorial entre a query e o fato, recência do fato (ponderada pelo tipo — uma decisão arquitetural decai muito mais lentamente do que um incidente operacional), importância intrínseca, confiança de veracidade, confiabilidade da fonte, sobreposição de entidades entre query e fato, penalidade por contradição com outro fato ativo e penalidade por obsolescência.
A fórmula:
score(fact, query) =
  (similaridade × 0.35) +
  (recência × 0.10) +
  (importância × 0.20) +
  (confiança_veracidade × 0.10) +
  (confiabilidade_fonte × 0.05) +
  (sobreposição_entidades × 0.10) +
  (prior_tipo × 0.10) -
  (penalidade_contradição × 0.15) -
  (penalidade_obsolescência × 0.10)
Os pesos iniciais sugeridos acima são razoáveis como ponto de partida, mas precisam ser calibrados com dados reais do seu domínio.
A função de recência usa decaimento exponencial com meia-vida configurável por tipo de fato:
def recency_score(reference_at, half_life_days=30):
    if reference_at is None:
        return 0.5
    age_days = (datetime.now(timezone.utc) - reference_at).total_seconds() / 86400
    return math.exp(-math.log(2) * age_days / half_life_days)
Para incidentes operacionais, half_life_days=7. Para decisões de arquitetura, half_life_days=180. Para preferências estáveis do usuário, half_life_days=365 ou mais.
O recall acontece em duas fases. Na primeira, candidate generation, o sistema busca 30 a 100 candidatos usando busca vetorial, busca léxica por trigrama e filtros por entidades. Na segunda, reranking cognitivo, aplica o scoring composto e seleciona os top-k.
Pilar 3: Evidence gaps
Este é o pilar que mais diferencia uma arquitetura madura de uma ingênua.
Quando a confiança agregada do recall fica abaixo de um threshold, o sistema não deve inventar uma resposta. Deve reconhecer a lacuna.
Os tipos de lacuna mais comuns:
missing_fact: fato relevante simplesmente não existe na memóriaconflicting_facts: dois fatos ativos se contradizem sem resoluçãostale_fact: fato encontrado, mas provavelmente desatualizadolow_confidence: evidência insuficiente para afirmar com segurançaunresolved_entity: entidade ambígua ou não resolvidainsufficient_context: query exige contexto maior do que o disponível
Quando detectada baixa confiança, o sistema percorre uma fallback ladder antes de declarar incerteza:
- Expandir o top-k vetorial
- Rodar busca léxica adicional
- Ampliar a janela temporal
- Buscar fatos relacionados via grafo de edges
- Consultar memória de sessão em cache
- Consultar fonte primária externa, se disponível
- Responder com incerteza explícita e registrar o gap
- Solicitar confirmação ao usuário se necessário
def resolve_with_evidence_gaps(query, tenant_id):
    recall = recall_memory(query, tenant_id)

    if recall["confidence"] >= 0.72:
        return recall

    expanded = broaden_retrieval(query, tenant_id)
    merged = merge_recall_results(recall, expanded)
    new_confidence = aggregate_recall_confidence(merged["facts"])

    if new_confidence < 0.72:
        gap = create_evidence_gap(
            tenant_id=tenant_id,
            recall_event_id=merged["recall_event_id"],
            gap_type="low_confidence",
            description=f"Evidência insuficiente para query: {query}",
            severity=1 - new_confidence,
        )
        merged["evidence_gap_id"] = gap
        merged["needs_clarification"] = True

    return merged
O comportamento esperado do agente quando há evidence gap: “Encontrei indícios, mas não evidência suficiente para afirmar com segurança” ou “A informação encontrada parece desatualizada; preciso confirmar a versão atual.”
Isso é qualitativamente diferente de responder com falsa convicção.
A stack e o papel de cada camada
A arquitetura usa quatro componentes com responsabilidades distintas.
Postgres é a verdade estrutural. Guarda fatos, fontes, versões, edges entre fatos, auditoria de recall e evidence gaps. Toda a rastreabilidade mora aqui.
pgvector é a camada de similaridade semântica dentro do Postgres. Adequado para a maioria dos sistemas corporativos em fase inicial, onde a cardinalidade ainda é administrável e simplicidade operacional tem valor.
Redis é a camada operacional de suporte: memória de sessão antes da consolidação, cache de embeddings e queries frequentes, locks de deduplicação e filas de reindexação.
Pinecone entra como acelerador vetorial quando o volume pressiona o Postgres. O conteúdo relacional e auditável permanece no Postgres; Pinecone cuida do throughput de busca semântica em escala.
A estratégia de rollout recomendada:
- Fase 1 (MVP confiável): Postgres + pgvector + Redis, com ingestão atômica, scoring composto básico, evidence gaps e auditoria de recall
- Fase 2 (robustez): versionamento completo, edges entre fatos, tuning de pesos baseado em dados reais
- Fase 3 (escala): Pinecone, reindexação assíncrona, learned reranker
O que isso resolve na prática
Com fatos atômicos, cada informação é atualizável, versionável e auditável de forma independente. Não há mais blocos conflitantes disputando o mesmo espaço semântico.
Com scoring composto, uma decisão arquitetural de seis meses atrás vence uma nota operacional de ontem quando a query é sobre arquitetura. O ranking reflete importância real, não apenas proximidade lexical recente.
Com evidence gaps, o agente sabe quando não sabe. Ele para de inventar. Ele registra a incerteza para auditoria. Ele busca clarificação quando necessário.
A auditabilidade completa — fonte do fato, componentes do score, confiança agregada, gap registrado — permite diagnosticar por que uma resposta foi gerada, não apenas se ela estava correta.
Thresholds iniciais para calibração
Como ponto de partida razoável:
- Confiança acima de 0.80: responder com alta convicção
- Entre 0.72 e 0.80: responder com ressalva leve
- Entre 0.55 e 0.72: tentar fallback antes de responder
- Abaixo de 0.55: registrar evidence gap, evitar afirmação forte
Esses valores precisam ser ajustados com um benchmark offline construído com casos reais do seu domínio.
Conclusão
A maioria dos sistemas de memória para agentes trata armazenamento como equivalente a cognição. Não é.
Armazenar texto e fazer nearest-neighbor é infraestrutura. Memória cognitiva é outra coisa: saber o que cada informação significa, quando ela é confiável, quanto peso ela merece e quando a evidência é insuficiente para responder.
Os três pilares descritos aqui — fatos atômicos, scoring composto e evidence gaps — não são complexidade desnecessária. São o mínimo necessário para que um agente em produção seja confiável.
Postgres sustenta a estrutura e a auditoria. pgvector ou Pinecone sustentam a recuperação semântica. Redis sustenta a velocidade operacional. Mas o valor real está na lógica de encoding, ranking e tratamento de incerteza.
Sem isso, o sistema apenas armazena texto e chama isso de memória.
O código completo dos fluxos de encoding, recall e evidence gaps, incluindo schema SQL e integração com Pinecone e Redis, está disponível no GitHub.
Se esse artigo foi útil, considere assinar a newsletter para receber os próximos na sua caixa.